把一次射门的成败全交给概率,会忽略三件能观察的事。乐鱼体育以预期进球模型为起点,逐项说明它的假设、它读不到的信息,以及普通读者可以如何补足这几步。
1、模型的核心输入是位置与角度
绝大多数公开模型用射门点距球门的距离、进球角度、身体部位以及此前的传球方式作为主要变量。这决定了它对"在哪儿射"敏感,对"射得怎么样"几乎无感。
2、守门员的起始位置决定真实难度
如果门将在前一回合被拉出球门、或者重心偏向一侧,那么同样的射门落点成功率就不同。多数统计把射门视为独立事件,不看门将的两秒前的位置,这会系统性低估某些机会的价值。
3、线路被遮挡与被封堵是两回事
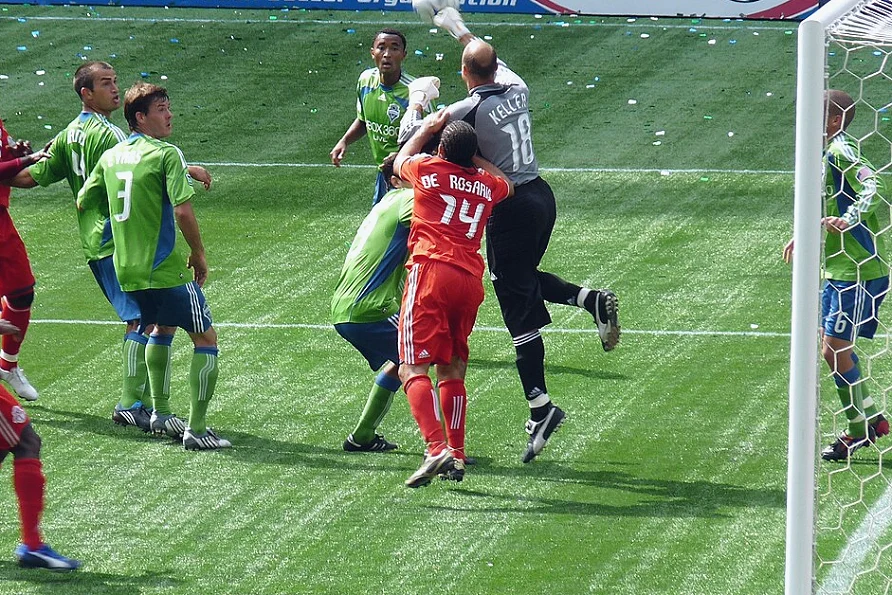
球从多名防守球员之间穿过、以及在最后一刻被伸出的腿改变方向,结果都算未进,但发生概率完全不同。前者通常是一次好机会,后者可能只是没提前观察。这类差别只能从录像里读。
4、连续不进会被误读成运气问题
把上面三项合起来看,一支球队若长期获得"姿势不好、门将未失位"的射门,那么模型给的预期进球本身就偏高,不是运气差。判断方法是看打正率与射门质量类型,而不是只比进球数与预期值。
5、二次进攻被严重低估的原因
被挡出的射门形成的补射,其预期进球常常被算作新的一次低质量机会,但此时门将通常已倒地、球门空着。这类事件在数据里被记成"补射",实际上可能是全场质量最高的一次。
6、传球环节同样需要修正
一次传中的难度取决于接球人是否需要转身、身后有没有空档以及门将是否已站位。把它只记成"助攻"或"未完成传球",会漏掉制造机会的质量。看组织型球员时,这一层与射门层一样重要。
把「模型的核心输入是位置与角度」与「线路被遮挡与被封堵是两回事」放在一起看,会发现它们是同一件事的两个方向:前者决定球队能不能把比赛推进到危险区域,后者决定推进到位之后能不能真正形成威胁。只盯其中一项,很容易对一场比赛得出片面结论,这也是我们做同类选题时坚持两条线都写的原因。
本篇的线索可以收成四句:模型的核心输入是位置与角度;线路被遮挡与被封堵是两回事;连续不进会被误读成运气问题;以及传球环节同样需要修正。四句话背后是同一个判断标准——能不能在对手针对之后仍然保持结构完整。这也是我们评价一场比赛时最常用的坐标。
关于这个话题,最常见的误解是把它当成单一原因的结果。实际上「传球环节同样需要修正」与「守门员的起始位置决定真实难度」之间是相互约束的关系:一端被加强,另一端往往会付出代价。真正值得讨论的是球队愿意把代价放在哪一边,而不是哪种做法绝对正确。
另一个容易被忽略的细节是时间分布:「守门员的起始位置决定真实难度」的成效通常在下半场前十几分钟最先显现,而「连续不进会被误读成运气问题」往往要到最后阶段才见分晓。把这两段时间的表现放在一起比较,比笼统统计全场数据更能说明问题,也更接近教练组赛后复盘的顺序。
如果把「连续不进会被误读成运气问题」单独拿出来看,它更像一面镜子:球队在没有球时的选择,往往比有球时更能说明训练质量。因为跑位可以临时提醒,而丢球后的第一反应只能靠长期训练建立,这也是为什么同一支球队在不同阶段的表现会差距明显。
指标是起点,不是结论
预期进球把比赛变得可比较,但它省略的部分恰好决定了成败。乐鱼体育在使用这类指标时,会把模型的输入项写出来,再补上三到四个只能通过观察获得的变量。